चिकित्सा छवियों की व्याख्या करने के लिए कृत्रिम बुद्धिमत्ता (एआई) उपकरणों का उपयोग करते समय डॉक्टरों को सावधानी बरतनी चाहिए, क्योंकि जिन क्षेत्रों पर प्रकाश डाला गया है एआई मॉडल हमेशा रेडियोलॉजिस्ट द्वारा पहचाने गए मॉडल के साथ संरेखित नहीं हो सकते हैंअंतर्राष्ट्रीय सूचना प्रौद्योगिकी संस्थान, हैदराबाद (IIIT-H) के शोधकर्ताओं के एक अध्ययन के अनुसार।
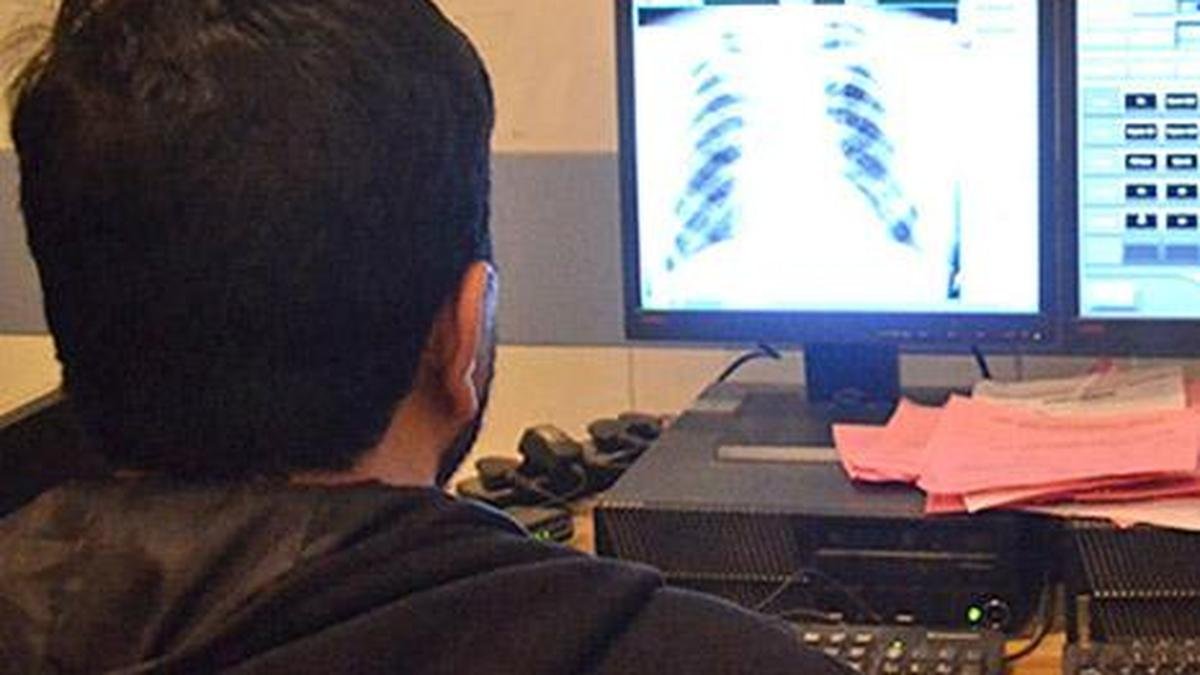
आईआईआईटी-एच में भाषा प्रौद्योगिकी अनुसंधान केंद्र (एलटीआरसी) द्वारा आयोजित अध्ययन में चार दृष्टि-भाषा मॉडल की जांच की गई छाती के एक्स-रे का विश्लेषण और मॉडलों द्वारा उजागर किए गए क्षेत्रों और रेडियोलॉजिस्ट द्वारा पहचाने गए क्षेत्रों के बीच विसंगतियां पाई गईं।
निष्कर्ष डॉक्टरों के लिए निदान के लिए पूरी तरह से उन पर निर्भर रहने के बजाय स्वतंत्र रूप से एआई-जनित आउटपुट का आकलन करने की आवश्यकता को रेखांकित करते हैं।
परमेश्वरी कृष्णमूर्ति के नेतृत्व में अनुसंधान दल ने यह निर्धारित करने की कोशिश की कि क्या एआई-जनित हीटमैप्स छवि के उन क्षेत्रों का सटीक रूप से प्रतिनिधित्व करते हैं जिन्हें रेडियोलॉजिस्ट रोग-संबंधी के रूप में पहचानेंगे।
हालाँकि, शोधकर्ताओं ने सवाल किया कि क्या ये दृश्य संकेतक आवश्यक रूप से किसी बीमारी के वास्तविक स्थान की पहचान करने की मॉडल की क्षमता को दर्शाते हैं।
“हम अनिवार्य रूप से यह जांचना चाहते थे कि क्या दृष्टि-भाषा मॉडल द्वारा बनाए गए हीटमैप्स वास्तव में उस जगह से मेल खाते हैं जहां रेडियोलॉजिस्ट, जो छवि को देखते हैं, कहेंगे कि बीमारी झूठ है,” “हाउ वेल डू चेस्ट एक्स-रे वीएलएम अटेंशन ओवरलेज़ मैच रेडियोलॉजिस्ट बॉक्स? एक क्रॉस-मॉडल ऑडिट और रेडियोलॉजिस्ट रीडर” शीर्षक वाले अध्ययन के प्रमुख अन्वेषक सैयद फैजान ने कहा।
टीम ने हजारों सार्वजनिक रूप से उपलब्ध छाती एक्स-रे के मुकाबले चार मॉडल, MAIRA-2, MedGemma-4B, LLaVA-Med-1.5, और LLaVA-1.5 का मूल्यांकन किया। उनका आकलन करने के लिए दो रेडियोलॉजिस्ट ने भी अध्ययन में भाग लिया, जिससे शोधकर्ताओं को एआई-जनित हाइलाइट्स की तुलना मानव मूल्यांकन से करने की अनुमति मिली।
मेडिकल इमेज कंप्यूटिंग और कंप्यूटर असिस्टेड इंटरवेंशन (MICCAI) 2026 पर अंतर्राष्ट्रीय सम्मेलन में स्वीकार किया गया अध्ययन, स्ट्रासबर्ग में iMIMIC सैटेलाइट इवेंट में प्रस्तुत किया जाना है।
शोधकर्ताओं ने पाया कि एक्स-रे के स्पष्ट रूप से सही क्षेत्र को उजागर करने वाले एआई मॉडल का मतलब यह नहीं है कि उसने रेडियोलॉजिस्ट की तरह ही बीमारी की पहचान की थी।
निदान के आधार पर हीटमैप
डॉ. फैजान के अनुसार, एक मॉडल पहले निदान पर पहुंच सकता है और फिर छवि से प्रभावित क्षेत्र की स्वतंत्र रूप से पहचान करने के बजाय, उस निष्कर्ष का उपयोग यह निर्धारित करने के लिए कर सकता है कि उसका हीटमैप कहां रखा जाए।
इस संभावना का परीक्षण करने के लिए, टीम ने नैदानिक जानकारी हटा दी और जांच की कि मॉडल असामान्यताओं को कैसे स्थानीयकृत करते हैं। उनके प्रदर्शन में गिरावट आई, जिससे पता चला कि निदान से जुड़ी शारीरिक अपेक्षाएं मॉडल द्वारा हाइलाइट किए गए क्षेत्रों को प्रभावित कर सकती हैं।
अध्ययन में तकनीकी ऑडिट और रेडियोलॉजिस्ट के आकलन में इन विभिन्न मॉडलों के प्रदर्शन में अंतर भी पाया गया।
डॉ. फैज़ान ने कहा कि इस अंतर ने नैदानिक दृष्टिकोण से एआई उपकरणों का आकलन करने के महत्व पर प्रकाश डाला है। एक मॉडल जो किसी संदिग्ध असामान्यता पर बारीकी से ध्यान केंद्रित करता है, वह रेडियोलॉजिस्ट को आवश्यक सभी जानकारी प्रदान नहीं कर सकता है, जिसमें यह भी शामिल है कि कोई बीमारी आसपास के क्षेत्रों में कितनी दूर तक फैल गई है।
जिस अंतर को संबोधित किया गया था
शोधकर्ताओं ने कहा कि उनके काम ने मेडिकल एआई सिस्टम के मूल्यांकन में एक अंतर को संबोधित किया है, क्योंकि पहले के अध्ययनों ने बड़े पैमाने पर भविष्यवाणी और नैदानिक सटीकता पर ध्यान केंद्रित किया था, न कि इस बात पर कि क्या एआई-हाइलाइट किए गए क्षेत्र रेडियोलॉजिस्ट द्वारा पहचाने गए क्षेत्रों से मेल खाते हैं।
पैराफ़्रेज़ मजबूती पर अध्ययन करें
एलटीआरसी दृष्टि-भाषा मॉडल में एक और संभावित कमजोरी की भी जांच कर रहा है – चिकित्सा प्रश्नों के शब्दों के प्रति उनकी संवेदनशीलता।
उदाहरण के लिए, डॉक्टर एक ही नैदानिक प्रश्न को अलग-अलग तरीके से व्यक्त कर सकते हैं, यह पूछना कि क्या छाती के एक्स-रे में निमोनिया दिखता है या क्या निमोनिया से इंकार किया जा सकता है। वे तकनीकी शब्दावली या अधिक परिचित अभिव्यक्तियों का भी उपयोग कर सकते हैं।
शोधकर्ताओं ने जांच की कि क्या एआई मॉडल ने पैराफ़्रेज़ मजबूती पर एक अध्ययन में अलग-अलग शब्दों में लिखे गए चिकित्सा प्रश्नों का लगातार जवाब दिया है।
अध्ययन ने पता लगाया कि चिकित्सा प्रश्नों के वाक्यांशों में परिवर्तन ने दृष्टि-भाषा मॉडल द्वारा उत्पन्न प्रतिक्रियाओं को कैसे प्रभावित किया है, जिससे यह सवाल उठता है कि क्या सिस्टम वास्तव में नैदानिक क्वेरी को समझते हैं या उपयोग किए गए सटीक शब्दों पर अत्यधिक निर्भर हैं।
सुश्री परमेश्वरी ने कहा कि प्रयोगशाला का व्यापक उद्देश्य स्वास्थ्य देखभाल में प्राकृतिक भाषा प्रसंस्करण (एनएलपी) को लागू करना और दस्तावेज़ीकरण, रिपोर्ट लेखन और रोगी-डॉक्टर संचार जैसे कार्यों में चिकित्सकों की सहायता के लिए बड़े भाषा मॉडल और दृष्टि-भाषा मॉडल का उपयोग करना था।
इसका उद्देश्य डॉक्टरों द्वारा नियमित प्रशासनिक कार्यों पर खर्च किए जाने वाले समय को कम करना और उन्हें नैदानिक निर्णय लेने पर अधिक ध्यान देने में सक्षम बनाना था।
शोधकर्ताओं ने इस बात पर जोर दिया कि मेडिकल एआई अनुसंधान का उद्देश्य चिकित्सकों का समर्थन करना होना चाहिए, न कि उन्हें प्रतिस्थापित करना, मानव निर्णय स्वास्थ्य देखभाल के लिए केंद्रीय होना चाहिए।
प्रकाशित – 09 अक्टूबर, 2026 12:13 अपराह्न IST